第 14 章 TTS 实战:语音合成与英语学习
🔊 本章特色:在《OpenClaw 实战指南》的系列章节中,本章系统讲解文本转语音(TTS)的技术原理、主流引擎选型,并结合 OpenClaw 的两个 Skill zhz-tts(语音合成工具)和 zhz-english-learning(英语学习材料生成器),从零搭建一套完整的英语学习系统。你提供课文,AI 负责出题、录音、排版。
本章目录:
| 节 | 内容 | 你将学到 |
|---|---|---|
| 1 | TTS 基础知识 | 什么是 TTS、技术演进、关键术语、TTS 与 ASR 的区别 |
| 2 | 主流 TTS 引擎介绍 | Edge-TTS、CosyVoice、OpenAI TTS、ElevenLabs 等;选型决策树 |
| 3 | TTS 配置与 zhz-tts Skill 实战 | /tts 斜杠命令、OpenClaw TTS 配置、Persona 人设、zhz-tts Skill 全流程 |
| 4 | zhz-english-learning Skill 实战 | 从课文到完整学习材料的 8 步工作流、4 个互动页面详解 |
| 5 | 综合实战:搭建英语学习系统 | 完整项目演示、对话式操作 |
| 6 | 总结与进阶 | 核心回顾、成本优化、进阶方向、课后练习 |
1. TTS 基础知识
1.1 什么是 TTS
TTS(Text-to-Speech,文本转语音) 是一种将文字自动转换为语音的技术。你输入一段文字,系统合成出一段可播放的音频文件,听起来就像一个真人在朗读。
我们日常接触到的 TTS 场景远比想象的多。手机上的 Siri 和小度智能音箱回复你时说的话,车载导航播报"前方 500 米右转"的声音,微信里"朗读"功能把文章念给你听的效果,有声书 App 里 AI 主播流畅的朗读,这些背后都是 TTS 技术在驱动。它们的共同特点是:不需要真人录音,由机器根据文字实时合成语音。
在 OpenClaw 实战中,TTS 的意义更加具体。它让智能体从"只会文字回复"变成"能开口说话"。当你对 OpenClaw 说"朗读这段课文",它会调用 TTS 引擎合成音频,然后把 MP3 文件或语音消息发送给你。如果你在微信或 Telegram 中接入 OpenClaw,合成的语音会以"语音消息条"的形式直接出现在聊天窗口中,就像收到一条真人录制的语音。
1.2 TTS 技术演进
TTS 不是近几年才出现的新事物。从最早的机械语音到今天几乎以假乱真的 AI 语音,它经历了四代清晰的技术演进。理解这条脉络,有助于你在后续的引擎选型中做出更合理的判断。
第一代:拼接合成(1960s-1990s)。 这是最原始的方法。工程师预先录制大量语音片段(如每个音节、每个词),需要合成时,再从数据库中检索对应的片段拼接起来。效果可想而知:声音断断续续,语调平板,听起来就像机器人在一个字一个字地往外蹦。早期的语音信箱和银行电话客服用的就是这种技术。如果你曾在 2000 年前后打过银行的电话查余额,那种一个字一个字拼出来的"您、的、余、额、是、三、千、五、百、元"就是典型的拼接合成。
第二代:参数合成(2000s)。 研究者们开始用统计模型(如隐马尔可夫模型 HMM)来建模语音的声学参数,包括基频、频谱、时长等,再用声码器(Vocoder)把这些参数转换成波形。代表性的开源项目有 Festival 和 eSpeak。相比拼接合成,参数合成的声音更连贯,不再有明显的拼接痕迹,但仍然带着一种"金属质感",一听就知道是机器在说话。eSpeak 至今仍是很多 Linux 发行版的默认屏幕阅读器引擎,因为它的体积只有几 MB,对硬件几乎没有要求。
第三代:神经网络 TTS(2016-2022)。 深度学习的到来彻底改变了 TTS 的面貌。Google 的 WaveNet 是这一代的开山之作,它用深层卷积网络直接建模原始音频波形,合成出的语音在自然度上实现了质的飞跃。随后的 Tacotron、Tacotron 2 等模型进一步简化了训练流程。微软的 Edge-TTS 就属于这一代技术的产品化成果:它基于微软 Azure 认知服务的神经语音引擎,通过 Edge 浏览器暴露出免费接口,提供 300 多种覆盖 100 多种语言的神经语音。本章将以 Edge-TTS 作为主力引擎。
第四代:大模型 TTS(2023 至今)。 大语言模型的能力延伸到了语音合成领域。以阿里 CosyVoice、OpenAI TTS、ChatTTS 为代表的新一代引擎,不仅音质更加自然,还带来了过去做不到的能力:情感控制(让语音带开心、悲伤、惊讶等情绪)、语音克隆(只需几秒的真人录音样本就能复制一个人的声音)、多轮对话语气(根据上下文自动调整语气和节奏)。这一代技术仍在快速迭代中。
总结来看,TTS 的发展遵循四条清晰的脉络。第一,从"念字"到"说话":早期 TTS 像朗读机器,现代 TTS 能表达情感、停顿和语气变化。第二,从昂贵到免费:过去 TTS 是昂贵的付费服务,现在 Edge-TTS 完全免费且音质出色,大幅降低了使用门槛。第三,从单语言到多语言:现代引擎支持上百种语言,中英文切换自如,不再需要为每种语言单独采购引擎。第四,从固定音色到可定制:CosyVoice 等大模型 TTS 支持用少量样本音频克隆声音,让每个人都有可能拥有自己专属的 AI 语音。
1.3 TTS 与 ASR:一对方向相反的技术
TTS 和 ASR 是语音领域的两大核心能力,它们的方向恰好相反。TTS 是把文字变成语音,可以理解为"朗读引擎"。ASR(Automatic Speech Recognition,自动语音识别)则是把语音变成文字,可以理解为"听力引擎"。
两者配合起来,就构成了一个完整的语音交互循环:你对着麦克风说话,ASR 把你的语音转成文字,AI 理解文字后生成回复,TTS 再把回复文字转成语音播放给你听。这正是智能语音助手(Siri、智能音箱小度)的工作方式。
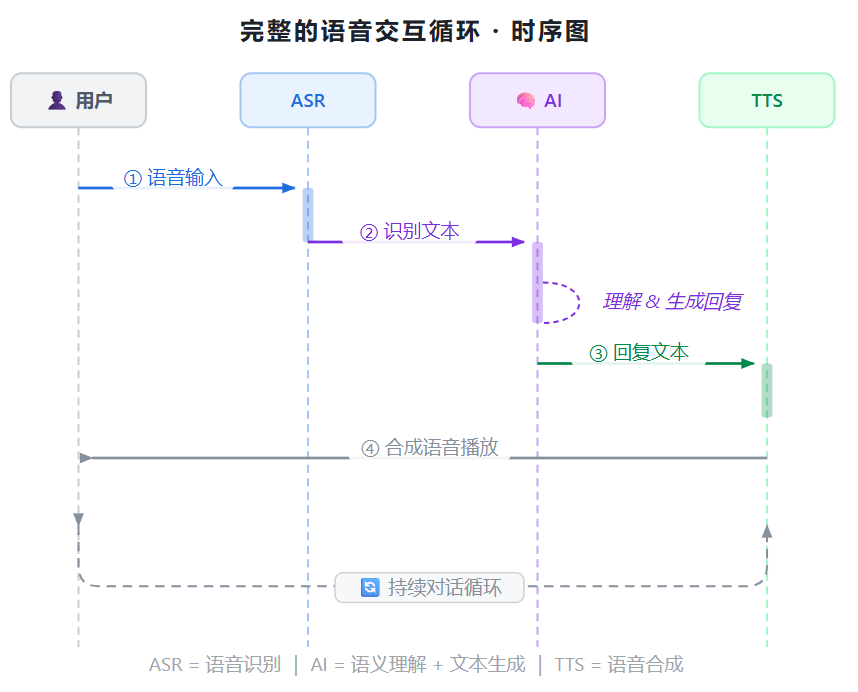
在 OpenClaw 实战中,TTS 是内置支持的能力,通过配置即可启用,自动为 AI 回复生成语音。而 ASR 方面,我们推荐使用操作系统自带的语音输入功能,无需任何额外配置和费用。具体来说:Windows 用户按 Win+H 即可打开系统语音听写;macOS 用户快速按两次 Fn 键即可启动语音输入;手机用户直接点击键盘上的麦克风图标。这些系统级语音输入会将你的口语实时转为文字填入输入框,然后按回车发送给 OpenClaw 即可。
1.4 关键术语速查
在进入具体的引擎和配置之前,先熟悉一下本章会频繁出现的几个关键术语。
音色(Voice) 指的是 TTS 使用的声音角色。就像你选一个播音员来朗读你的文章,你可以选男声、女声、美式口音、英式口音等。每个 TTS 引擎都会提供一组预设音色供选择。
语速(Rate) 控制朗读的快慢。通常用百分比表示,如 +20% 表示加速 20%,-10% 表示减速 10%。在英语听力练习场景中,稍慢的语速(如 -10%)能帮助学习者更清楚地听出每个单词的发音。
音调(Pitch) 控制声音的高低。男声通常音调较低,女声音调较高。调整音调可以改变声音的"性格",比如提高音调会让声音听起来更友好、更年轻。
采样率(Sample Rate) 是每秒钟对声音信号采样的次数,单位是 Hz。24kHz 对于语音朗读已经足够清晰,48kHz 则更加细腻,但文件也更大。在日常语音合成场景中,这个参数通常不需要手动调整。
码率(Bitrate) 是音频文件的压缩密度,单位是 kbps。码率越高,音质越好,但文件也越大。MP3 格式的语音文件通常使用 64kbps 或 128kbps,对于语音朗读场景完全够用。
神经语音(Neural Voice) 指用深度学习技术合成的自然声音,区别于早期拼接合成和参数合成的机械感声音。目前主流的 TTS 引擎(Edge-TTS、CosyVoice、OpenAI TTS 等)都属于神经语音。
Persona 是 OpenClaw 的语音人设概念。你可以预设多套声音配置(音色、语速、音调的组合),给每套配置取一个名字(如 female-tutor 或 male-tutor),然后在聊天中通过 /tts persona 命令快速切换。
MP3 是目前最通用的音频压缩格式,扩展名为 .mp3。它的体积约为无损 WAV 格式的十分之一,同时在语音朗读场景中音质完全够用。所有设备和平台都支持 MP3 播放,本章中所有的音频输出均为 MP3 格式。
1.5 TTS 的能力边界
了解 TTS 能做什么和不能做什么,能帮助你在后续实战中设定合理的预期。
TTS 非常擅长的场景包括:朗读课文、单词、文章,生成听力练习音频,语音消息推送(天气播报、提醒通知),制作有声书和播客素材,以及语言学习中的发音示范。这些场景有一个共同特点:内容是预先确定的文字,TTS 只需要忠实地把它念出来。
TTS 目前还不太擅长的场景包括:唱歌(需要专门的歌声合成模型如 Suno),完美复刻某个特定人的声音(需要语音克隆技术和相应的授权),实时对话中自然的停顿和"嗯""啊"等填充词(虽然在快速改善中),以及方言和口音的精确模拟(部分模型支持,但效果有限)。
2. 主流 TTS 引擎介绍
选 TTS 引擎就像选配音演员,不同引擎的音质、价格、语言支持各有千秋。本节介绍四款最值得关注的 TTS 引擎,并给出选型建议。
2.1 引擎全景对比
| 引擎 | 开发者 | 价格 | 音质 | 中文支持 | 延迟 | 需要 API Key |
|---|---|---|---|---|---|---|
| Edge-TTS | 微软 | 免费 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | 低(1-3s) | ❌ 不需要 |
| CosyVoice | 阿里云 DashScope | 💰 按量 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 中(3-5s) | ✅ 需要 |
| OpenAI TTS | OpenAI | 💰 按量 | ⭐⭐⭐⭐ | ⭐⭐⭐ | 低(1-2s) | ✅ 需要 |
| ElevenLabs | ElevenLabs | 💰 订阅制 | ⭐⭐⭐⭐⭐ | ⭐⭐ | 中(2-4s) | ✅ 需要 |
| Azure 认知服务 | 微软 | 💰 按量 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 低(1-2s) | ✅ 需要 |
2.2 Edge-TTS:免费之王
Edge-TTS 是本章项目的核心引擎。它调用微软 Edge 浏览器内置的在线神经 TTS 服务,完全免费,无需注册,无需 API Key。这听起来好得不太真实,但它确实是免费的:微软通过 Edge 浏览器向用户提供这项服务,而开源社区将这个接口封装成了一个 Python 库 edge-tts,让任何人都可以在命令行或脚本中使用。
Edge-TTS 提供了超过 300 种神经语音,覆盖 100 多种语言和地区。中英文质量均很出色,非常适合双语教学场景。它支持语速、音调、音量的精细调节,OpenClaw 也内置了对 Edge-TTS 的支持(OpenClaw 中称之为 microsoft provider),开箱即用。
它的主要局限在于三个方面:依赖微软在线服务(需要联网),音色不可自定义(不能克隆自己的声音),以及长文本偶尔不稳定(可能超时或触发限流)。对于本章的英语学习场景来说,这些局限都不构成问题。
Edge-TTS 本质是开源社区对微软 Edge 浏览器内置接口的封装,并非微软官方对外承诺的服务。微软可能随时调整接口策略,导致服务中断。对于重要的教学项目或生产环境,建议准备备选引擎(如 CosyVoice 或 Azure 认知服务)。
安装与环境变量设置
Edge-TTS 通过 Python 包 edge-tts 提供命令行工具。安装非常简单:
pip install edge-tts
安装完成后,你可能会发现直接在终端输入 edge-tts 命令无法识别。这是因为 edge-tts 的可执行文件位于 Python 的用户级 Scripts 目录中,而这个目录默认不在系统的 PATH 环境变量里。
有两种解决方式。第一种是设置 PATH 环境变量,把 edge-tts 所在目录加入系统搜索路径。第二种,也是我们推荐的方式,是直接使用 python -m edge_tts 来调用,这种方式不需要配置 PATH,在任何环境下都能正常工作。
如果你希望设置 PATH(以 Windows 为例),可以在 PowerShell 中临时执行:
$env:PATH = "$env:PATH;$(python -m site --user-base)\Scripts"
这条命令将 Python 用户级 Scripts 目录添加到当前窗口的 PATH 中,仅对当前 PowerShell 窗口有效,关闭后失效。如需永久生效,需要在"系统属性 → 高级 → 环境变量 → 用户变量"中找到 Path,添加 %APPDATA%\Python\Python3x\Scripts(将 3x 替换为你的实际 Python 版本号,如 312)。
macOS 和 Linux 用户则可以在 ~/.bashrc 或 ~/.zshrc 中添加:
export PATH="$PATH:$(python3 -m site --user-base)/bin"
无论是否配置 PATH,都可以用以下方式验证安装成功:
python -m edge_tts --version
正常输出类似 edge-tts 7.3.1,表示安装成功。
使用以下命令来查看其命令行选项:
python -m edge_tts --help
输入参考如下:
python -m edge_tts --help
usage: __main__.py [-h] [-t TEXT] [-f FILE] [-v VOICE] [-l] [--rate RATE] [--volume VOLUME] [--pitch PITCH]
                  [--write-media WRITE_MEDIA] [--write-subtitles WRITE_SUBTITLES] [--proxy PROXY] [--version]

Text-to-speech using Microsoft Edge's online TTS service.

options:
  -h, --help            show this help message and exit
  -t TEXT, --text TEXT  what TTS will say
  -f FILE, --file FILE  same as --text but read from file
  -v VOICE, --voice VOICE
                        voice for TTS. Default: en-US-EmmaMultilingualNeural
  -l, --list-voices     lists available voices and exits
  --rate RATE           set TTS rate. Default +0%.
  --volume VOLUME       set TTS volume. Default +0%.
  --pitch PITCH         set TTS pitch. Default +0Hz.
  --write-media WRITE_MEDIA
                        send media output to file instead of stdout
  --write-subtitles WRITE_SUBTITLES
                        send subtitle output to provided file instead of stderr
  --proxy PROXY         use a proxy for TTS and voice list.
  --version             show program's version number and exit
基本使用方式
Edge-TTS 的命令行参数非常直观。以下是最常用的几种操作:
# 合成一段英文语音
python -m edge_tts --voice en-US-JennyNeural --text "Hello, how are you?" --write-media hello.mp3

# 合成一段中文语音
python -m edge_tts --voice zh-CN-XiaoxiaoNeural --text "你好,世界" --write-media nihao.mp3

# 调整语速(减速 10%)
python -m edge_tts --voice en-US-JennyNeural --rate="-10%" --text "Good morning!" --write-media slow.mp3

# 从文件读取文本
python -m edge_tts --voice en-US-JennyNeural --file article.txt --write-media article.mp3

# 查看所有可用音色
python -m edge_tts --list-voices
其中 --voice 指定使用的音色,--text 指定要合成的文本(-t 是其缩写),--file 从文件读取文本(-f 是其缩写),--write-media 指定输出文件路径,--rate 调整语速(如 +20% 加速、-10% 减速),--list-voices 列出所有可用的音色。
如果你需要查看特定语言的音色,可以用系统命令过滤输出。例如在 PowerShell 中查看所有美式英语音色:
python -m edge_tts --list-voices | Select-String "en-US"
在 macOS/Linux 中:
python -m edge_tts --list-voices | grep "en-US"
2.3 CosyVoice:阿里云大模型语音合成
CosyVoice 是阿里云推出的大模型语音合成引擎,属于"第四代 TTS"。它在中文语音合成方面的质量极高,自然度接近真人,是中文场景下最值得考虑的付费方案。
CosyVoice 的核心优势在于三个方面。首先是中文质量,它对中文的韵律、语调、多音字处理都非常到位,明显优于 Edge-TTS 的中文音色。其次是情感控制能力,你可以让语音表现出开心、悲伤、惊讶等情绪。第三是语音克隆功能,只需提供几秒的真人录音样本,就能生成一个高度相似的 AI 声音。CosyVoice 还提供了一些有趣的预设音色,比如东北口音(longlaotie)和书生风格(longshu),让中文语音合成有了更多个性化的选择。
使用 CosyVoice 需要阿里云 DashScope 的 API Key,按调用量计费(约 ¥0.15/千字符),成本较低。具体价格请以阿里云百炼(DashScope)控制台的最新报价为准,不同模型版本的计费方式可能不同。总体而言,对于个人学习场景,成本是可控的。
使用前需要设置环境变量:
# Windows PowerShell
$env:DASHSCOPE_API_KEY = "***"

# macOS / Linux
export DASHSCOPE_API_KEY="***"
CosyVoice 的常用音色包括:longxiaochun(温柔女声)、longxiaoxia(甜美女声)、longxiaochen(沉稳男声)、longxiaobai(清朗男声)、longlaotie(东北口音)、longshu(书生风格)。
2.4 选型决策树
面对这么多引擎,该如何选择?以下是一个简化的决策思路:
如果你需要免费、零配置、中英文双语支持,选 Edge-TTS。这也是本章的默认选择。
如果你追求中文语音的极致质量,或者需要情感控制和语音克隆功能,选 CosyVoice。
如果你已有 OpenAI API Key 且主要处理英文内容,OpenAI TTS 是最简单的方案。
如果你需要多语言声音克隆和极致音质,且预算充足,ElevenLabs 是目前业界公认音质最好的 TTS 服务。
如果你是企业用户,需要 SLA 保障和企业级支持,Azure 认知服务是最稳妥的选择。
本章选择 Edge-TTS 作为主力引擎,理由是:免费、无需 API Key、OpenClaw 内置支持、中英文质量均满足教学场景。CosyVoice 作为备选方案,在需要更高中文质量时使用。
3. TTS 配置与 zhz-tts Skill 实战
本节将 OpenClaw 的 /tts 斜杠命令、TTS 系统配置和 zhz-tts Skill 一起讲解。/tts 命令让你在聊天中快速控制语音输出,TTS 配置文件实现持久化设置,zhz-tts Skill 则让你用命令行精确控制语音文件的生成。
3.1 /tts 斜杠命令详解
OpenClaw 提供了一组以 /tts 开头的斜杠命令,用于在聊天中实时控制语音合成行为。这些命令由 Gateway 网关直接处理,不经过 AI 模型推理,因此执行速度快、结果可预测。你可以把它们理解为 OpenClaw 语音功能的"遥控器"。
命令速查表
| 命令 | 功能 | 说明 |
|---|---|---|
/tts on |
开启自动语音 | 此后每条 AI 回复都会自动生成语音 |
/tts off |
关闭自动语音 | 只返回文字,不再生成语音 |
/tts status |
查看当前状态 | 显示引擎、音色、语速、模式等完整信息 |
/tts audio <文字> |
一次性语音合成 | 将指定文字转为语音,不影响自动模式设置 |
/tts latest |
朗读上一条回复 | 重听 AI 刚刚说过的内容 |
/tts persona <id> |
切换语音人设 | 在不同音色配置之间快速切换 |
/tts persona off |
清除人设 | 恢复使用默认声音 |
/tts limit <数字> |
设置最大朗读字数 | 超过该字数的回复会先摘要再朗读 |
实战操作演示
开启自动语音模式。 在聊天中输入 /tts on,OpenClaw 会回复确认,并从此在每条回复后自动附带一段语音。这个模式非常适合英语听力练习、睡前故事朗读等需要持续语音输出的场景。当你想关闭语音时,输入 /tts off 即可。
一次性生成语音。 如果你不想开启自动模式,只是偶尔需要听某句话的发音,可以使用 /tts audio 命令。例如输入 /tts audio Good morning! How are you today?,OpenClaw 会返回一段语音消息,而不会改变当前的自动语音设置。这个命令在查单词发音、听句子朗读时非常实用。
查看当前状态。 输入 /tts status,OpenClaw 会显示当前 TTS 的完整配置信息,包括:是否启用、使用哪个引擎(Provider)、当前音色(Voice)、语速(Rate)、音调(Pitch)、当前人设(Persona)、朗读字数上限等。这是排查语音问题时的第一步。
重听上一条回复。 输入 /tts latest,OpenClaw 会重新朗读上一条回复的内容。当你没听清或者想再听一遍时,这个命令很方便,省去了重新输入文字的麻烦。
设置朗读字数上限。 输入 /tts limit 500,将朗读字数上限设为 500 字。当 AI 的回复超过这个字数时,OpenClaw 会先对内容进行摘要,再朗读摘要部分,避免语音过长。默认的字数上限是 1500 字。
/tts 命令在日常场景中的应用
| 场景 | 操作 | 效果 |
|---|---|---|
| 英语听力练习 | /tts on |
每条回复都朗读,沉浸式听力训练 |
| 查单词发音 | /tts audio pronunciation |
只听某个词的发音 |
| 睡前故事 | /tts on 后让 AI 讲故事 |
自动朗读完整故事 |
| 没听清刚才说的 | /tts latest |
重听上一句 |
| 切换老师声音 | /tts persona male-tutor |
从女老师切换到男老师 |
| 安静环境不想出声 | /tts off |
暂时关闭语音 |
3.2 OpenClaw TTS 系统配置
/tts 命令适合临时操作,而配置文件则用于持久化设置,让 OpenClaw 每次启动都使用你偏好的语音配置。
基础配置
编辑 openclaw.json(通常位于 ~/.openclaw/openclaw.json),添加 TTS 配置段:
{
  "tts": {
    "auto": "always",
    "provider": "microsoft",
    "providers": {
      "microsoft": {
        "enabled": true,
        "speakerVoice": "en-US-MichelleNeural",
        "lang": "en-US",
        "outputFormat": "audio-24khz-48kbitrate-mono-mp3"
      }
    }
  }
}
这里有几个关键配置项需要理解。
auto 控制自动语音的行为模式,有三个取值。"always" 表示每条回复都自动生成语音,适合听力练习场景。"voice" 表示仅在收到语音消息时才用语音回复(即"你说语音我也说语音,你打字我也打字"),适合混合交互场景。"off" 表示不自动生成语音,需要手动用 /tts audio 命令触发。
provider 指定默认 TTS 引擎。在 OpenClaw 中,Edge-TTS 对应的 provider 名称是 "microsoft"。这个命名初看可能有些困惑,但逻辑是清晰的:Edge-TTS 本质上就是微软 Azure 认知服务的神经语音引擎,OpenClaw 通过这个 provider 名称调用微软的语音合成能力。
providers 是引擎的详细配置块。enabled 设为 true 启用该引擎;speakerVoice 指定具体的音色 ID;lang 指定语言区域;outputFormat 指定输出音频的格式和编码,"audio-24khz-48kbitrate-mono-mp3" 表示 24kHz 采样率、48kbps 码率的单声道 MP3 文件,对于语音朗读场景音质足够且文件体积小。
OpenClaw 启动后,可以通过 /tts status 命令查看当前生效的配置。
Persona 人设系统:男声/女声一键切换
Persona 是 OpenClaw 中一个非常实用的功能。它允许你预设多套声音配置(音色、语速、音调的组合),给每套配置取一个标识名,然后在聊天中通过 /tts persona <id> 命令快速切换。
这对于英语教学场景特别有用:你可以预设一个女老师人设和一个男老师人设,学生根据自己的偏好选择,或者在不同练习场景中切换。
创建 Persona 的完整步骤
第一步:确定人设方案。 在动手编辑配置之前,先想清楚需要几个人设、每个人设的角色定位。以英语教学为例,我们设计两个人设:一个温暖的女老师(适合日常教学和跟读练习),一个清晰的男老师(适合对比听力训练)。
第二步:为每个人设选择音色。 从前面的音色速查表中挑选合适的音色。女老师选 en-US-JennyNeural(温暖亲切),男老师选 en-US-GuyNeural(沉稳清晰)。选择的原则是音色要自然、辨识度高、长时间听不累。
第三步:编辑 openclaw.json。 在 tts 配置段中添加 personas 字段。以下是一个完整的、可直接使用的配置示例:
{
  "tts": {
    "auto": "always",
    "provider": "microsoft",
    "persona": "female-tutor",
    "personas": {
      "female-tutor": {
        "label": "女老师 Emma",
        "description": "温暖女声,适合英语教学",
        "provider": "microsoft",
        "providers": {
          "microsoft": {
            "enabled": true,
            "speakerVoice": "en-US-JennyNeural",
            "lang": "en-US",
            "outputFormat": "audio-24khz-48kbitrate-mono-mp3"
          }
        }
      },
      "male-tutor": {
        "label": "男老师 David",
        "description": "清晰男声,适合英语教学",
        "provider": "microsoft",
        "providers": {
          "microsoft": {
            "enabled": true,
            "speakerVoice": "en-US-GuyNeural",
            "lang": "en-US",
            "outputFormat": "audio-24khz-48kbitrate-mono-mp3"
          }
        }
      }
    },
    "providers": {
      "microsoft": {
        "enabled": true,
        "speakerVoice": "en-US-MichelleNeural",
        "lang": "en-US",
        "outputFormat": "audio-24khz-48kbitrate-mono-mp3"
      }
    }
  }
}
第四步:保存文件。 OpenClaw 会自动检测配置文件的变更并热加载,通常不需要手动重启。如果修改后没有立即生效,可以用 openclaw restart 命令重启 Gateway。
配置字段详解
| 字段 | 位置 | 说明 |
|---|---|---|
persona |
tts 顶层 |
当前激活的人设 ID(如 "female-tutor"),决定 OpenClaw 启动后默认使用哪套声音 |
personas |
tts 顶层 |
所有人设的定义集合,键名即人设 ID |
label |
人设内部 | 人设的显示名称,会出现在 /tts status 输出和切换确认消息中 |
description |
人设内部 | 人设的简短描述,帮助你记住这个人设的用途 |
provider |
人设内部 | 该人设使用的 TTS 引擎,通常与顶层 provider 一致 |
providers |
人设内部 | 该人设的引擎详细参数,可以覆盖顶层 providers 中的同名配置 |
enabled |
providers 内部 |
是否启用该引擎,设为 false 可临时禁用而不删除配置 |
speakerVoice |
providers 内部 |
具体的音色 ID,如 en-US-JennyNeural |
lang |
providers 内部 |
语言区域代码,如 en-US(美式英语)、zh-CN(简体中文) |
outputFormat |
providers 内部 |
输出音频格式,推荐使用 "audio-24khz-48kbitrate-mono-mp3" |
注意配置的优先级:人设内的 providers 配置会覆盖顶层的 providers 配置。这意味着每个人设可以有完全独立的引擎参数,互不影响。
验证 Persona 配置
配置完成后,需要通过以下步骤验证人设是否正确生效。
验证 1:查看当前状态。 在聊天中输入 /tts status,OpenClaw 会返回当前 TTS 的完整配置信息。重点检查以下几项是否正确显示:
Provider: microsoft
Voice: en-US-JennyNeural
Persona: female-tutor (女老师 Emma)
Auto: always
如果显示的 Voice 与你配置的人设中 speakerVoice 一致,说明配置已正确加载。
验证 2:试听语音效果。 用 /tts audio 命令生成一段测试语音,确认声音是否符合预期:
你:/tts audio Hello, this is a test. My name is Emma.
OpenClaw:🔊(播放 JennyNeural 女声朗读的语音)
仔细听语音是否清晰自然、是否是女声、语速是否正常。如果声音听起来像男声或者音色不对,说明配置可能没有正确加载,需要回到 openclaw.json 检查。
验证 3:切换人设并对比。 依次切换不同的人设,用相同的测试文本生成语音,对比差异:
你:/tts persona male-tutor
OpenClaw:✅ Persona switched to: 男老师 David (en-US-GuyNeural)

你:/tts audio Hello, this is a test. My name is David.
OpenClaw:🔊(播放 GuyNeural 男声朗读的语音)

你:/tts persona female-tutor
OpenClaw:✅ Persona switched to: 女老师 Emma (en-US-JennyNeural)

你:/tts audio Hello, this is a test. My name is Emma.
OpenClaw:🔊(播放 JennyNeural 女声朗读的语音)
两次语音的音色应该有明显的男女声区别。如果都能正常播放且声音不同,说明 Persona 系统工作正常。
验证 4:清除人设恢复默认。 输入 /tts persona off 可以清除当前人设,恢复使用顶层 providers 中的默认声音(即 en-US-MichelleNeural):
你:/tts persona off
OpenClaw:✅ TTS persona disabled.

你:/tts status
OpenClaw:
  📊 TTS status
  State: ✅ enabled
  Chat override: default
  Provider: microsoft (✅ configured)
  Persona: none
  Text limit: 1500 chars
  Auto-summary: on
常见问题排查
| 问题 | 可能原因 | 解决方法 |
|---|---|---|
/tts status 不显示 Persona |
配置文件未正确加载 | 检查 JSON 语法(可用在线 JSON 校验工具),然后 openclaw restart |
| 切换人设后声音没变 | 人设 ID 拼写错误 | 确认 /tts persona 后面的 ID 与配置文件中 personas 的键名完全一致 |
| 语音播放失败 | 网络问题或音色 ID 无效 | 先用 python -m edge_tts --list-voices 确认音色 ID 存在,再检查网络连接 |
| 配置改了但不生效 | OpenClaw 未检测到文件变更 | 手动执行 openclaw restart 重启 Gateway |
添加更多 Persona 的思路
掌握了基本创建方法后,你可以根据需要扩展更多人设。例如添加一个中文老师人设:
"chinese-tutor": {
  "label": "中文老师小红",
  "description": "自然中文女声,用于课文翻译朗读",
  "provider": "microsoft",
  "providers": {
    "microsoft": {
      "enabled": true,
      "speakerVoice": "zh-CN-XiaoxiaoNeural",
      "lang": "zh-CN",
      "outputFormat": "audio-24khz-48kbitrate-mono-mp3"
    }
  }
}
添加后在聊天中用 /tts persona chinese-tutor 即可切换。同一个人设系统可以容纳任意数量的声音配置,只需保证每个 ID 唯一即可。
在聊天中切换人设
配置完成后,日常使用非常简单:
你:/tts persona female-tutor
OpenClaw:✅ TTS persona set to female-tutor.

你:/tts persona male-tutor
OpenClaw:✅ TTS persona set to male-tutor.

你:/tts persona off
OpenClaw:✅ TTS persona disabled.
常用 Edge-TTS 音色速查
| 音色 ID | 语言 | 性别 | 特点 | 适合场景 |
|---|---|---|---|---|
en-US-MichelleNeural |
美式英语 | 女 | 温暖清晰 | 英语陪练(首选女声) |
en-US-JennyNeural |
美式英语 | 女 | 专业友好 | 正式教学 |
en-US-AriaNeural |
美式英语 | 女 | 活泼年轻 | 青少年对话 |
en-US-GuyNeural |
美式英语 | 男 | 沉稳清晰 | 英语陪练(首选男声) |
en-GB-RyanNeural |
英式英语 | 男 | 标准英音 | 英式发音训练 |
en-GB-SoniaNeural |
英式英语 | 女 | 标准英音 | 英式口语练习 |
zh-CN-XiaoxiaoNeural |
中文 | 女 | 温暖自然 | 中文解释辅助 |
zh-CN-YunxiNeural |
中文 | 男 | 年轻活力 | 中文朗读 |
zh-CN-YunyangNeural |
中文 | 男 | 新闻播报 | 正式场合 |
3.3 zhz-tts Skill:双引擎语音合成工具
zhz-tts 是一个 OpenClaw Skill,它封装了 Edge-TTS 和 DashScope CosyVoice 两个引擎,提供统一的命令行接口。它与 OpenClaw 内置 TTS 的区别在于:内置 TTS 是为 AI 回复自动配音,而 zhz-tts 是一个"主动式"工具,你明确告诉它要合成什么文字、保存到哪里,它执行后给你一个 MP3 文件。
这种区分在实战中很有意义。当你需要为课文生成独立的音频文件、为单词表批量生成发音音频、或者在脚本中自动化处理大量文本时,zhz-tts 是更合适的选择。
Skill 结构
zhz-tts/
├── SKILL.md           # Skill 定义文件(元数据 + 操作指南)
└── scripts/
    └── main.py        # 核心脚本(支持双引擎)
安装依赖
pip install edge-tts requests pyyaml
快速上手
# 英文朗读(自动 0.9 倍速,这是 zhz-tts 的特色设计)
python scripts/main.py -t "The quick brown fox jumps over the lazy dog." -a fox.mp3

# 从文件朗读整篇文章
python scripts/main.py --textfile article.txt -a article.mp3

# 中文朗读(正常速度)
python scripts/main.py -t "你好世界" -a hello.mp3

# 使用 DashScope CosyVoice 引擎
python scripts/main.py -t "你好" -a hello.mp3 -e dashscope -v longxiaochun

# 查看所有可用音色
python scripts/main.py --list-voices
注意 zhz-tts 的 --textfile 参数和原始 edge-tts 的 --file(或 -f)参数名称不同。zhz-tts 作为封装层,提供了自己统一的参数命名风格。
命令行参数详解
| 参数 | 短参数 | 说明 | 默认值 |
|---|---|---|---|
--text |
-t |
要合成的文本 | 无 |
--textfile |
无 | 从文件读取文本 | 无 |
--audio |
-a |
输出 MP3 文件路径 | output.mp3 |
--engine |
-e |
TTS 引擎:edge 或 dashscope |
edge |
--voice |
-v |
音色名称 | 根据语言自动选择 |
--rate |
-r |
语速,如 +20%、-10% |
英文 -10%,中文 +0% |
--volume |
无 | 音量,如 +20% |
+0% |
--model |
-m |
DashScope 模型 ID | cosyvoice-v3-flash |
英文听力 0.9 倍速:一个贴心的设计
zhz-tts 有一个特色设计值得单独说明:当你输入英文文本时,它默认以 0.9 倍速朗读(即 --rate "-10%")。
为什么要这样做?在英语听力练习中,正常语速对初学者来说往往太快,来不及分辨每个单词的发音细节。而 0.9 倍速是一个经过实践验证的"甜蜜点":它比正常速度慢一点,足以让你听清每个单词的发音;但又不会慢到失真或听起来不自然。这个速度特别适合跟读、听写和模仿发音。
当然,你可以通过 --rate 参数覆盖默认值。需要更慢速度(如初学者练习难句)时设为 -20%(0.8 倍速),需要正常速度(如复习阶段)时设为 +0%:
# 默认 0.9 倍速(适合日常练习)
python scripts/main.py -t "Good morning, how are you today?" -a greeting.mp3

# 0.8 倍速(更慢,适合初学者或难句)
python scripts/main.py -t "The photosynthesis process is fascinating." -a slow.mp3 -r "-20%"

# 正常速度(适合复习和进阶)
python scripts/main.py -t "Good morning!" -a normal.mp3 -r "+0%"
双引擎对比
同一个中文句子,分别用两个引擎生成,可以直观感受差异:
# Edge-TTS(免费,音质良好)
python scripts/main.py -t "今天天气真好,适合出去散步。" -a weather_edge.mp3

# CosyVoice(付费,音质更自然)
python scripts/main.py -t "今天天气真好,适合出去散步。" -a weather_cosy.mp3 -e dashscope -v longxiaochun
| 对比维度 | Edge-TTS | CosyVoice |
|---|---|---|
| 中文自然度 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 英文自然度 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 成本 | 免费 | ¥0.15/千字符 |
| 需要 API Key | ❌ | ✅ |
| 延迟 | 1-3 秒 | 3-5 秒 |
实际使用的推荐策略是:英文内容用 Edge-TTS,免费且英文质量高;中文高质量场景用 CosyVoice。
注意:CosyVoice 的核心优势在中文,其英文合成质量明显弱于 Edge-TTS。请勿用 CosyVoice 生成英文教学音频,否则学生会学到不自然的发音和语调。
3.4 音频格式小知识:MP3
本章所有音频输出均为 MP3 格式。MP3 是 MPEG-1 Audio Layer III 的缩写,是 1993 年由德国弗劳恩霍夫协会开发的有损压缩音频格式。经过三十多年的发展,它已成为世界上最普及的音频格式。
MP3 的核心优势在于压缩效率高(体积约为无损 WAV 格式的十分之一),兼容性极强(几乎所有设备和播放器都支持),且在语音朗读场景下音质完全够用。语音信号的频率范围主要在 300Hz 到 8kHz 之间,远低于音乐信号,因此不需要很高的采样率和码率就能保证清晰的听感。本章使用的 MP3 文件典型码率为 64kbps 到 128kbps,对于语音朗读来说绰绰有余。
值得一提的是 MP3 的专利与版权问题。MP3 的编解码技术曾受多项专利保护,由弗劳恩霍夫协会和 Technicolor(原 Thomson)持有并收取许可费。在专利有效期内,任何商业软件如果内置 MP3 编码或解码功能,都需要向专利持有方支付授权费用,这也是早期一些开源播放器选择 Ogg Vorbis 等替代格式的原因之一。2017 年 4 月,弗劳恩霍夫协会宣布最后一批 MP3 相关专利到期,不再续期,Technicolor 的 MP3 许可项目也随之终止。这意味着从今天起,MP3 编解码技术已完全进入公有领域,任何人和组织都可以自由地开发、分发和使用 MP3 编码器与解码器,无需支付任何专利许可费用。对于我们使用 Edge-TTS 和 ffmpeg 生成 MP3 文件来说,不存在任何法律风险。
如果你需要将 MP3 转换为其他格式,可以用 ffmpeg 命令行工具:
# MP3 转 WAV(无损格式,文件较大)
ffmpeg -i input.mp3 output.wav

# MP3 转 Opus(微信语音消息使用的格式)
ffmpeg -i input.mp3 -c:a libopus output.opus
OpenClaw 在发送语音消息时会自动处理格式转换,通常不需要手动操作。
3.5 在 OpenClaw 对话中使用 zhz-tts
安装 zhz-tts Skill 后,你可以直接在 OpenClaw 对话中让 AI 生成语音文件。例如:
你:把这段话转成语音文件,保存到 sounds 目录:"The cat sat on the mat."
OpenClaw 会自动识别 zhz-tts Skill,调用对应的命令,生成 MP3 文件并告诉你保存路径:
OpenClaw:✅ 语音已生成:sounds/cat.mp3(0.9 倍速,女声朗读)
4. zhz-english-learning Skill 实战
zhz-english-learning 是一个完整的英语学习材料生成器。你只需提供一篇英文课文,它就会自动生成单词列表、音频文件、课文翻译和 4 个互动学习页面。整个过程完全自动化,你不需要手动执行每一步。
4.1 项目全景:一篇课文变出一套学习材料
为了让你对最终产出有一个直观的认识,这里先展示完整的输入输出关系:
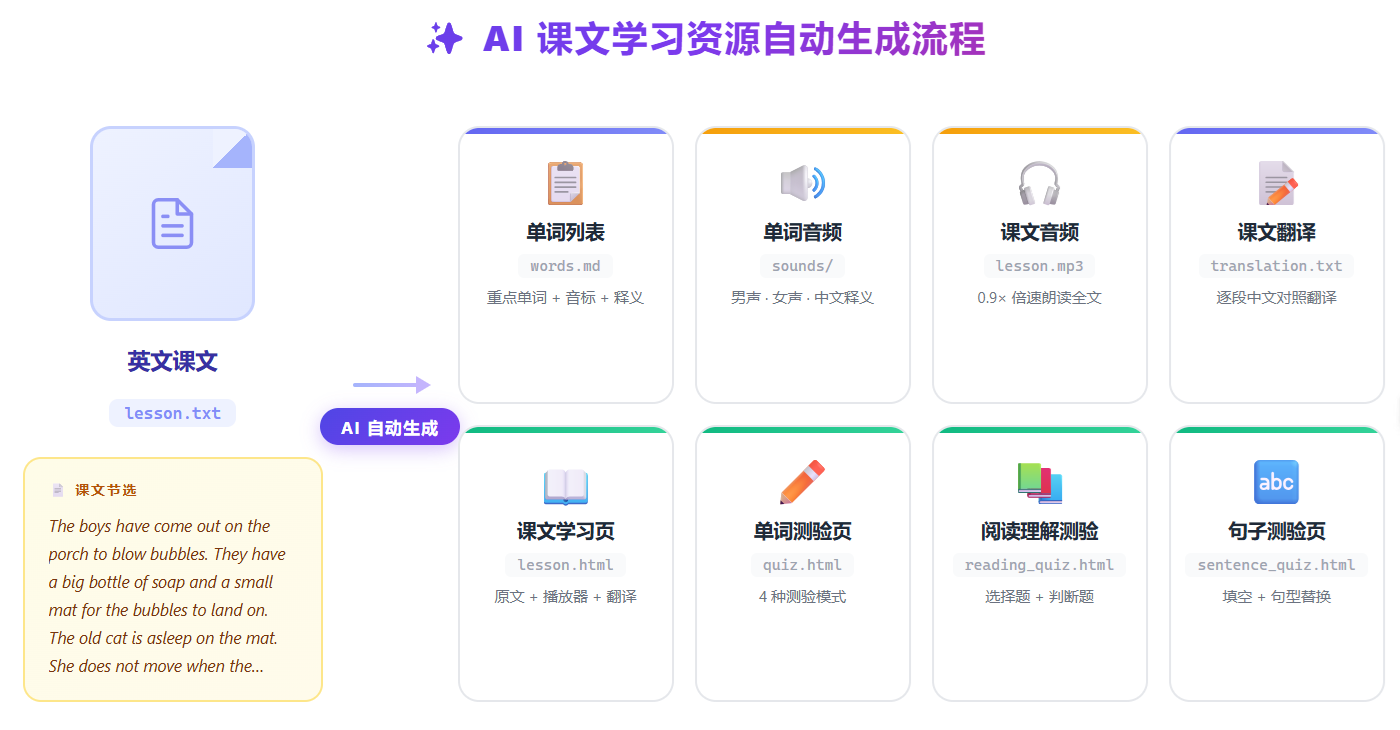
输入是:一篇英文课文(lesson.txt)
生成单词列表、单词音频、课文音频、课文翻译和 4 个互动学习页面:
- 课文学习页(lesson.html):原文 + 音频播放器 + 中文翻译
- 单词测验页(quiz.html):4 种测验模式
- 原文理解测验页(reading_quiz.html):选择题 + 判断题
- 句子测验页(sentence_quiz.html):填空 + 句型替换
4 个 HTML 页面共享左侧导航栏,可在页面间自由跳转。在手机等移动设备上,导航栏会自动变为顶部横向导航,方便手指操作。
4.2 安装技能
在 OpenClaw 中安装技能非常简单:
# 在 OpenClaw web页面对话框中输入
/clawhub install zhz-english-learning
或者在终端中输入 clawhub install zhz-english-learning
安装完成后,技能文件会存放在:
~/.openclaw/workspace/skills/zhz-english-learning/
目录结构如下:
zhz-english-learning/
├── SKILL.md                           # Skill 定义文件
└── scripts/
    ├── generate_word_audio.py         # 单词音频生成
    ├── generate_text_audio.py         # 课文音频生成
    ├── generate_lesson_page.py        # 课文学习页生成
    ├── generate_word_quiz.py          # 单词测验页生成
    ├── generate_reading_quiz.py       # 原文理解测验页生成
    └── generate_sentence_quiz.py      # 句子测验页生成
每个 Python 脚本都是独立的命令行工具,可以被 OpenClaw 的 exec 工具直接调用,也可以在终端中手动运行。这种设计使得每一步都可以单独调试和验证。
4.3 八步工作流详解
步骤 1:提取单词
你提供课文原文(如 txt/lesson.txt),OpenClaw 自动从中提取 5 到 20 个重点单词,保存为 md/words.md。提取的原则是优先选择课文中的关键词,排除过于简单的常用词(如 the、is、and),确保选出的词有学习价值。
输出格式是一个 Markdown 表格,包含英文单词、IPA 音标、词性缩写和中文释义四列:
# 单词列表

| English | Phonetic | POS | Chinese |
|---------|----------|-----|---------|
| porch | /pɔːrtʃ/ | n. | 门廊 |
| bubble | /ˈbʌb.əl/ | n. | 泡泡 |
| burst | /bɜːrst/ | v. | 破裂 |
| soap | /soʊp/ | n. | 肥皂 |
| gentle | /ˈdʒen.təl/ | adj. | 轻柔的 |
词性使用简写:n.(名词)、v.(动词)、adj.(形容词)、adv.(副词)、prep.(介词)、conj.(连词)、pron.(代词)、det.(限定词)。音标使用国际音标(IPA)格式,这是英语学习中最通用的音标体系。
步骤 2:生成单词音频
python scripts/generate_word_audio.py -w md/words.md -o sounds
这一步为每个单词生成 3 个 MP3 文件。以单词 "porch" 为例,会生成 porch_male.mp3(男声朗读,使用 en-US-GuyNeural 音色)、porch_female.mp3(女声朗读,使用 en-US-JennyNeural 音色)和 porch_chinese.mp3(女声朗读中文释义"门廊",使用 zh-CN-XiaoxiaoNeural 音色)。所有文件保存在 sounds/ 目录下。
同时,脚本还会生成一个 words.mp3 合集文件,按顺序朗读所有单词,每个单词的朗读顺序是:男声英文、女声英文、女声中文。单词之间有适当的停顿,适合当作听力练习材料连续播放。
为什么每个单词要 3 个音频?男声和女声让学生感受不同的发音风格,有助于建立更立体的语音记忆。中文释义音频则让初学者也能理解词义,不必翻看单词表,在"盲听"模式下也能学习。
步骤 3:生成课文音频
python scripts/generate_text_audio.py --textfile txt/lesson.txt -o sounds/lesson.mp3
默认使用 Edge-TTS 女声,以 0.9 倍速朗读整篇课文。可通过参数调整语速和音色:
# 更慢速度(0.85 倍,适合初学者)
python scripts/generate_text_audio.py --textfile txt/lesson.txt -o sounds/lesson.mp3 -r "-15%"

# 指定男声朗读
python scripts/generate_text_audio.py --textfile txt/lesson.txt -o sounds/lesson.mp3 -v en-US-GuyNeural
步骤 4:生成课文翻译
OpenClaw 根据课文内容自动生成中文翻译,保存为 txt/translation.txt。翻译逐段对应原文,便于学生在学习页中对照阅读。这一步利用的是 OpenClaw 已配置的大语言模型能力,不需要额外的翻译 API。
步骤 5:生成课文学习页
python scripts/generate_lesson_page.py -t txt/lesson.txt -a sounds/lesson.mp3 -o lesson.html --translation txt/translation.txt
生成的 lesson.html 是一个自包含的单文件 HTML 页面,包含四个功能模块:原文展示区完整显示英文课文;内置音频播放器支持播放、暂停和倍速控制(可切换 0.75x、1x、1.25x 等速度);中文翻译区域可展开或收起,方便学生先尝试自主理解,再看翻译对照;侧边栏导航提供到其他三个学习页面的快捷入口。
步骤 6:生成单词测验页
python scripts/generate_word_quiz.py -w md/words.md -s sounds -o quiz.html
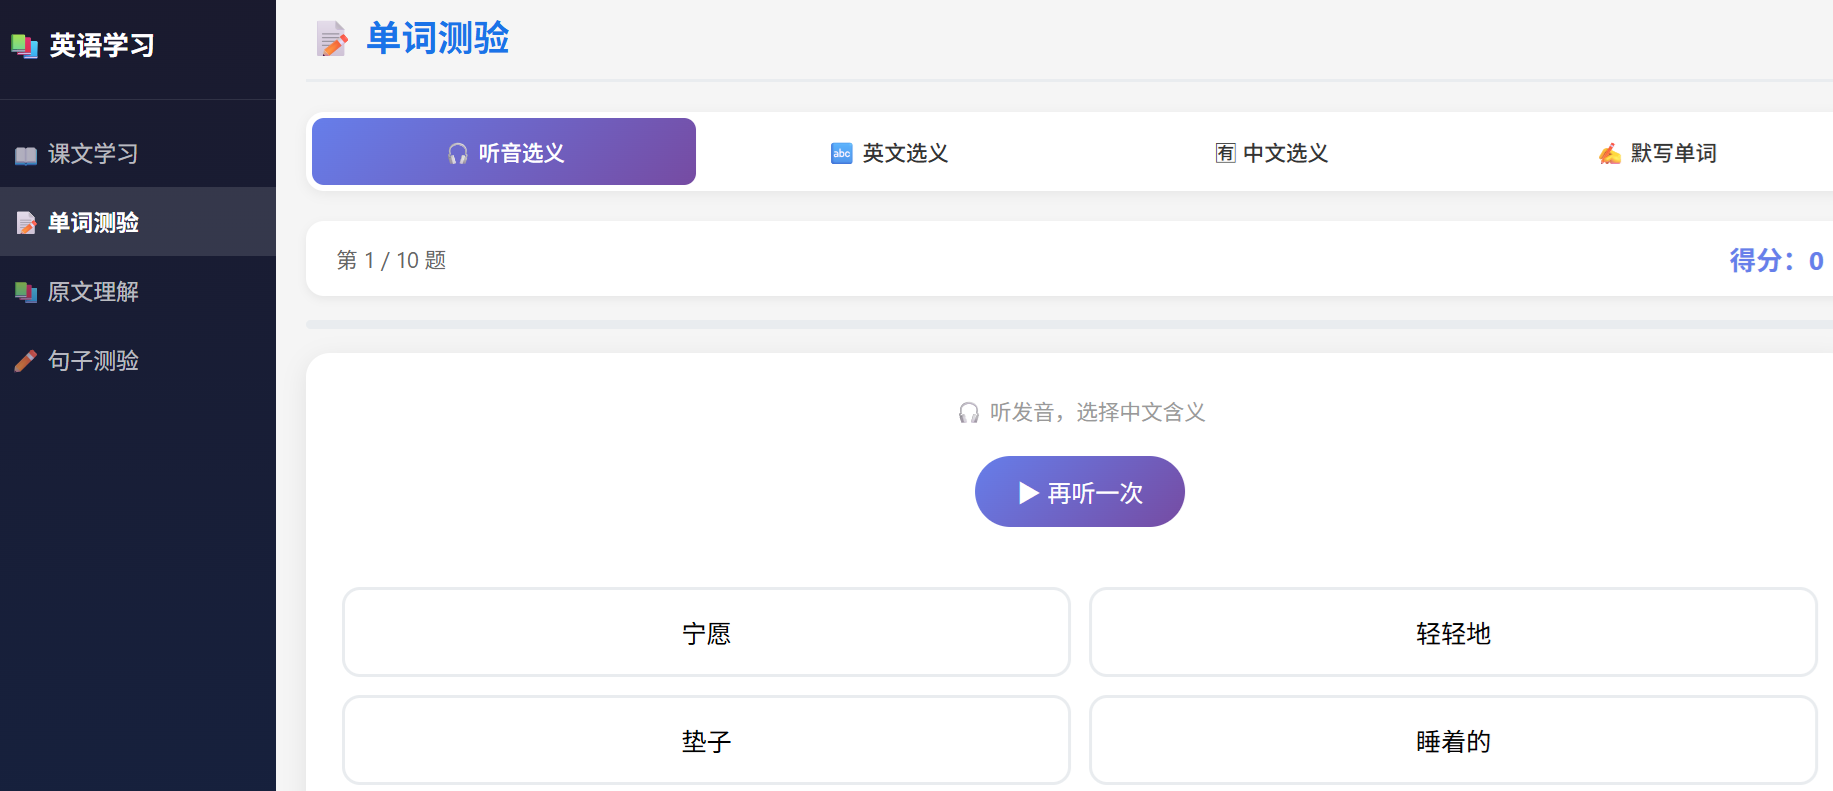
单词测验页包含 4 种测验模式,覆盖词汇学习的不同维度:
听音选义:播放英文发音两遍(先男声后女声),学生从四个中文选项中选出正确含义。这种模式训练的是"听到英语能理解意思"的能力,是最基础的听力辨识训练。
英文选义:显示英文单词的同时播放发音,学生选择对应的中文含义。这种模式结合了视觉和听觉,适合词汇记忆阶段使用。
中文选义:显示中文含义并播放发音,学生从四个英文选项中选出正确的单词。这是一种逆向记忆训练,难度比前两种更高。
默写单词:显示中文含义,学生需要手动输入英文单词。提交后系统会播放正确发音供核对。这是最难的模式,训练的是拼写能力。
每种模式都配有音频播放,确保学生在"看"的同时也在"听",充分利用多感官学习的效果。
步骤 7:生成原文理解测验页
OpenClaw 先根据课文内容生成理解题目(JSON 格式),再用脚本生成测验页面:
python scripts/generate_reading_quiz.py -q json/reading_questions.json -o reading_quiz.html
题目类型有两种。选择题(choice)是标准的四选一格式,例如"What did the boys come out to do?"配合 A/B/C/D 四个选项。判断题(judge)是 True/False 二选一格式,例如"The bubble burst on the cat's back."让学生判断对错。每道题都附带解析说明,引用原文出处帮助学生理解为什么选这个答案。
步骤 8:生成句子测验页
python scripts/generate_sentence_quiz.py -q json/sentence_questions.json -o sentence_quiz.html
句子测验同样有两种题型。搭配填空(fill)要求学生从备选词中选择正确的词填入句子中的空格,例如"The boys came out to blow ___."的答案是 bubbles。句型替换(transform)给出一个原句和改写提示,让学生从四个选项中选择正确的改写形式,例如将"is asleep"替换为"is sleeping",考察现在进行时的用法。
4.4 生成的文件结构
整个项目的文件按照类型分别存放,结构清晰:
project/
├── md/
│   └── words.md               # 单词列表
├── txt/
│   ├── lesson.txt             # 课文原文(用户提供)
│   └── translation.txt        # 中文翻译(AI 生成)
├── json/
│   ├── reading_questions.json # 原文理解题目(AI 生成)
│   └── sentence_questions.json# 句子练习题目(AI 生成)
├── lesson.html                # 📖 课文学习页
├── quiz.html                  # 📝 单词测验页
├── reading_quiz.html          # 📚 原文理解测验页
├── sentence_quiz.html         # ✏️ 句子测验页
├── words.mp3                  # 单词音频合集
└── sounds/                    # 音频文件目录
    ├── {word}_male.mp3
    ├── {word}_female.mp3
    ├── {word}_chinese.mp3
    └── lesson.mp3
4.5 在 OpenClaw 中的对话式操作
整个八步工作流不需要你手动执行每一步命令。只需在 OpenClaw 对话中用自然语言描述需求,OpenClaw 会自动识别 zhz-english-learning Skill,按工作流依次执行:
你:帮我用这篇课文生成英语学习材料(附上 lesson.txt 内容)
OpenClaw 会逐步完成单词提取、音频生成、课文朗读、翻译生成和 4 个页面的创建。全程自动,你只需等待完成后打开 HTML 文件使用即可。
5. 综合实战:搭建英语学习系统
本节把 /tts 命令、TTS 配置、zhz-tts 和 zhz-english-learning 串联起来,在 OpenClaw 中从零搭建一套完整的英语学习系统。
5.1 项目目标
给一位初中生,用一篇英文课文,生成全套自学材料:音频、翻译、4 个互动练习页。
5.2 环境准备
第一步:安装依赖。 在终端中执行以下命令安装所需的 Python 包:
pip install edge-tts pydub requests pyyaml
其中 pydub 用于音频拼接操作(如生成单词合集音频时需要拼接多个文件),它依赖系统安装的 ffmpeg。如果尚未安装 ffmpeg,可以从 ffmpeg.org 下载或包管理器安装。
第二步:确认 Edge-TTS 可用。 执行以下命令验证安装:
python -m edge_tts --version
正常输出类似 edge-tts 7.2.8。
第三步:配置 OpenClaw TTS。 在 openclaw.json 中配置 Persona 人设(男老师和女老师),配置方法参见 3.2 节的详细说明。
第四步:确认 Skill 已安装。 执行 openclaw skills list 确认 zhz-tts 和 zhz-english-learning 两个 Skill 都在列表中。
5.3 实战演示:从课文到全套材料
假设课文内容如下(保存为 txt/bubbles.txt):
The boys have come out on the porch to blow bubbles.
They have a big bottle of soap and a small mat for the bubbles
to land on. The old cat is asleep on the mat. She does not move
when the bubbles land on her back. One bubble floats up and
catches the light. It looks like a tiny rainbow. Then it bursts
with a gentle pop. The boys laugh and blow more bubbles...
在 OpenClaw 对话中操作:
你:请用这篇课文生成一套英语学习材料
OpenClaw 自动执行 8 步流程,最终生成以下文件:
| 输出文件 | 说明 |
|---|---|
lesson.html |
课文学习页:原文 + 音频播放器 + 中文翻译 |
quiz.html |
单词测验页:4 种测验模式 |
reading_quiz.html |
原文理解:选择题 + 判断题 |
sentence_quiz.html |
句子练习:填空 + 句型替换 |
sounds/lesson.mp3 |
课文朗读音频(0.9 倍速) |
sounds/*.mp3 |
单词音频(每词 3 个文件) |
words.mp3 |
单词合集音频 |
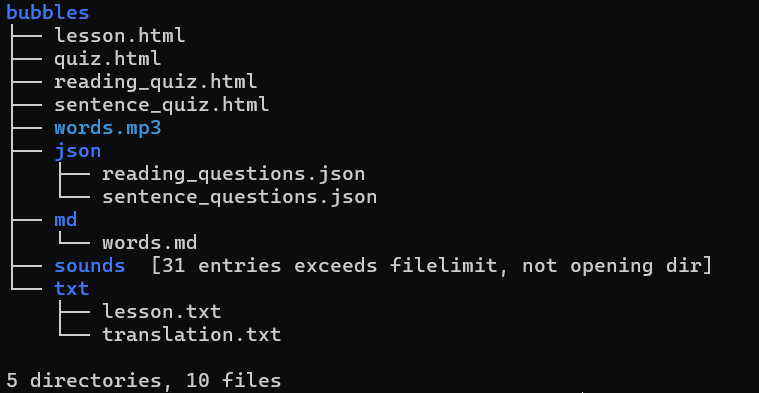
用浏览器打开 lesson.html 即可开始学习。页面左侧有导航栏,可在 4 个页面间切换。音频播放器支持倍速控制,学生可以反复听、跟读、做练习。
5.4 完整对话流程回顾
以下是一次完整的操作流程记录,展示了 /tts 命令和两个 Skill 的协作方式:
你:/tts on
OpenClaw:🔊 TTS enabled.(附带语音)

你:/tts persona female-tutor
OpenClaw:✅ 已切换到女老师 Emma。(女声朗读确认)

你:帮我用这篇课文生成英语学习材料(附课文内容)
OpenClaw:好的!我正在为你生成学习材料...
          ✅ 单词提取完成:8 个重点词汇
          ✅ 单词音频生成完成:24 个 MP3 文件
          ✅ 课文音频生成完成:lesson.mp3(0.9 倍速)
          ✅ 课文翻译完成
          ✅ 4 个学习页面已生成
          打开 lesson.html 开始学习吧!(女声朗读)

你:/tts audio The boys have come out on the porch to blow bubbles.
OpenClaw:🔊(朗读这句课文)

你:/tts persona male-tutor
OpenClaw:✅ 已切换到男老师 David。(男声朗读确认)

你:/tts latest
OpenClaw:🔊(男声重新朗读上一条内容)
这段对话展示了 /tts 命令(控制语音输出)和 Skill(生成学习材料)如何无缝配合。你始终在用自然语言与 OpenClaw 交互,底层的命令调用、文件生成、音频合成全部由 OpenClaw 自动完成。
6. 总结与进阶
6.1 本章核心知识回顾
| 知识点 | 关键要点 |
|---|---|
| TTS 原理 | 四代演进:拼接→参数→神经网络→大模型;现代 TTS 音质接近真人 |
| 引擎选型 | 免费首选 Edge-TTS,中文高质量选 CosyVoice,英文极致选 OpenAI TTS |
| Edge-TTS 安装 | pip install edge-tts,使用 python -m edge_tts 调用,无需 PATH 配置 |
/tts 命令 |
/tts on/off/status/audio/latest/persona/limit,在聊天中实时控制语音 |
| Persona 人设 | 预设多套声音配置,用 /tts persona <id> 快速切换 |
| zhz-tts Skill | 双引擎统一接口、英文默认 0.9 倍速、命令行批量操作 |
| zhz-english-learning | 课文→单词+音频+翻译+4 页面,8 步全自动生成 |
| MP3 格式 | 通用音频格式,体积小、兼容性强,适合语音朗读场景 |
6.2 成本优化策略
| 策略 | 说明 | 节省幅度 |
|---|---|---|
| 优先用 Edge-TTS | 免费、无需 API Key、音质足够好 | 100%(vs 付费引擎) |
| 英文用 Edge、中文用 CosyVoice | 各取所长,避免对英文内容使用付费引擎 | 60-80% |
| 缓存已生成的音频 | 相同内容不重复生成 | 避免重复调用 API |
| 批量生成时降低采样率 | 48kHz 语音朗读用 24kHz 足够 | 文件体积减半 |
6.3 课后练习
- 基础:用
python -m edge_tts生成一段英文自我介绍的 MP3 文件,调整语速为 0.8 倍 - 进阶:提供一篇英文课文,用 zhz-english-learning 生成全套学习材料,在浏览器中完成 4 个练习页面
- 高级:配置 Persona 男声/女声,用
/tts persona命令切换,为同一篇课文分别生成男声和女声版本的音频,对比听感差异 - 挑战:编写一个自动化脚本,读取一个文件夹下的所有
.txt课文,为每篇生成课文音频并保存为 MP3
本章完
本文为《OpenClaw 实战指南》系列第 14 篇。