第 7 章 一条消息的旅程:OpenClaw 请求处理全流程
🎯 本章特色:从用户按下发送键到收到回复,一条消息在 OpenClaw 内部经历了怎样的旅程?本章以"请记住我的生日"这条真实消息为例,逐帧拆解五个处理阶段,让你看清智能体协作的每一个齿轮。
本章目录:
| 节 | 内容 | 你将学到 |
|---|---|---|
| 1 | 从一条消息说起 | 一个具体场景引出全流程概览 |
| 2 | 核心组件与职责 | 用户、渠道层、Gateway、大模型、工具层各自的边界 |
| 3 | 流程总览:五个阶段 | 消息接收、思考决策、工具执行、回复生成、消息发送 |
| 4 | 实例解析:"请记住我的生日" | 用真实案例逐阶段走完全流程 |
| 5 | 完整时序图与数据流 | 可视化各组件的交互顺序 |
| 6 | 流程优化与性能调优 | 减少调用、并行化、缓存、精简提示词 |
| 7 | 总结与进阶 | 核心知识回顾、课后练习 |
1. 从一条消息说起
让我们从一个具体的时刻开始。
2026 年 3 月 20 日上午 9 点 55 分,用户在北京西城区的家中打开浏览器,在 OpenClaw 的网页聊天界面中输入了一行文字:
请记住 3 月 10 日是我的生日
按下发送键的那一刻,用户可能认为这只是一个简单的请求,就像对朋友说"帮我记着这件事"一样自然。但在屏幕背后,一场精密的协作正在上演。这条只有十几个汉字的简短消息,将穿越五个处理阶段,经过多个核心组件的接力配合,在不到两秒的时间内完成从接收、理解、执行到回复的整个生命周期。
理解这个流程,是理解 OpenClaw 如何工作的关键。它不仅能帮助开发者诊断问题、优化性能,更能让我们看清智能体与人类协作的本质:不是魔法,而是一系列可预测、可调试、可优化的工程步骤。
在交互式请求处理路径中,Gateway(网关)是唯一与大模型直接交互的组件。渠道层只负责消息的接收和发送,不接触大模型、不执行工具、不管理会话状态。
接下来,我们先认识参与这场"接力赛"的五位选手。
2. 核心组件与职责
在深入流程之前,先认识参与请求处理的核心组件。它们各司其职,通过明确的接口协作,共同完成从用户消息到回复的转换。
2.1 用户(User)
用户是整个流程的起点和终点。从系统架构的角度看,用户通过某种渠道与 OpenClaw 交互,发送消息并接收回复。用户不需要知道系统内部有多少组件、经过多少阶段。用户感知的只是"发送消息,收到回复"这个简单过程。系统复杂度对用户完全透明,这是良好用户体验的关键。
2.2 渠道层(Channel/Provider)
渠道层(Channel/Provider,消息渠道适配器) 是 OpenClaw 与外部世界的接口,负责将不同渠道的消息转换为系统内部统一格式,并将回复转换回渠道私有格式。
渠道层的核心职责包括:
- 消息接收:通过 WebSocket、HTTP Webhook、Bot API 等协议接收来自用户的原始消息
- 格式转换:将渠道私有格式(如 Telegram 的 JSON 结构、微信的 XML 格式)转换为 OpenClaw 内部统一格式
- 消息发送:将 Gateway 返回的回复转换为渠道格式,推送给用户
- 协议适配:处理各渠道特有的认证、限流、重连等逻辑
- 认证管理:验证消息来源的合法性
以 webchat 为例,渠道层通过 WebSocket 接收用户消息,提取核心字段(文本内容、发送时间、会话 ID),转换为 OpenClaw 内部格式,转发给 Gateway。收到 Gateway 返回的回复后,再通过 WebSocket 推送给用户。
渠道层不做什么:不接触大模型 API、不执行工具调用、不管理会话状态、不组装上下文。
渠道层与大模型解耦,带来两个关键好处:
| 好处 | 说明 | 示例 |
|---|---|---|
| 新增渠道不影响核心 | 只需实现渠道插件 | 添加 WhatsApp 支持,Gateway 和大模型完全不需要改动 |
| 更换大模型不影响渠道 | 只需修改 Gateway 配置 | 从通义千问切换到 DeepSeek,所有渠道插件继续正常工作 |
常见的渠道类型包括 webchat(WebSocket)、Telegram(Bot API)、Discord(Gateway API)、WhatsApp(Business API)、Slack(Events API)等。
2.3 Gateway(网关)
Gateway(网关,系统核心调度器) 是 OpenClaw 的核心组件,是整个系统的"大脑"。它负责接收渠道层的消息、组装上下文、调用大模型、执行工具、管理会话状态,并将回复返回给渠道层。
Gateway 的核心职责包括:
- 上下文组装:加载系统提示、会话历史、记忆片段,拼接成完整 Prompt(提示词)
- 大模型调用:将 Prompt 发送给大模型,接收思考结果
- 工具调度:解析大模型的工具调用计划,执行具体操作,收集结果
- 会话管理:维护对话历史、Token 计数、会话状态
- 错误处理:捕获各阶段异常,决定重试或降级
- 日志记录:统一记录所有交互细节,供后续分析和调试
几乎所有核心逻辑都集中在 Gateway,这样的设计有三个关键优势:
第一,状态集中管理。 所有会话状态(历史对话、记忆内容、Token 用量)都存储在 Gateway,渠道层无状态。这意味着同一个用户可以通过不同渠道与同一个会话交互,会话状态不会因为渠道切换而丢失。
第二,权限集中控制。 工具调用的权限检查在 Gateway 统一进行,渠道层不需要知道工具的存在。这样可以防止渠道层被恶意利用执行未授权操作。
第三,日志集中记录。 所有工具调用、大模型交互、错误信息都在 Gateway 统一记录,便于后续分析和调试。
2.4 大模型(LLM)
大模型(LLM,Large Language Model,大型语言模型) 是 OpenClaw 的"智能引擎",负责理解用户意图、规划工具调用、生成自然语言回复。
在整个请求处理流程中,Gateway 会与大模型进行多次交互。典型的交互模式如下:
| 交互轮次 | 输入内容 | 输出内容 | 目的 |
|---|---|---|---|
| 第 1 轮 | 系统提示 + 会话历史 + 用户消息 | 工具调用计划(JSON) | 决策要做什么 |
| 第 2 轮 | 系统提示 + 会话历史 + 用户消息 + 工具执行结果 | 自然语言回复 | 生成用户可读的回复 |
如果工具调用需要多轮(比如先查目录再写文件),交互轮次会更多。
大模型有几个明确的边界:不直接访问文件系统、不直接调用网络 API、不直接管理会话状态、不直接发送消息给用户。大模型与外部系统解耦,带来两个关键好处:
- 安全性:大模型只能"建议"执行什么操作,实际执行由 Gateway 控制。Gateway 可以在执行前进行权限检查、参数验证、风险评估
- 可替换性:更换大模型只需修改 Gateway 配置,不影响工具层和渠道层
2.5 工具层(Tools)
工具层(Tools,工具执行引擎) 是 OpenClaw 的"手脚",负责执行具体的操作,如读写文件、执行命令、控制浏览器、搜索网络等。
工具层的核心职责包括:
- 文件操作:read(读取)、write(写入)、edit(编辑)
- 命令执行:exec(运行 Shell 命令)
- 网络访问:web_search(搜索)、web_fetch(抓取网页)
- 浏览器控制:screen(驱动 UI)
- 消息发送:message(向渠道发送消息)
工具层不决定调用哪个工具,这个决策由大模型做出。工具层也不直接与大模型通信,而是通过 Gateway 中转。
工具层与大模型解耦,带来两个关键好处:
- 工具可复用:同一个工具可以被不同的大模型调用,不需要为每个大模型单独实现
- 工具可扩展:新增工具只需实现工具接口,Gateway 和大模型都能自动识别
下面这张表总结了五个组件的边界划分:
| 组件 | 核心职责 | 不做什么 |
|---|---|---|
| 用户 | 发送消息、接收回复 | 不关心内部实现 |
| 渠道层 | 消息格式转换、协议适配 | 不接触大模型、不执行工具 |
| Gateway | 上下文组装、调度、状态管理 | 不直接生成回复内容 |
| 大模型 | 意图理解、工具规划、回复生成 | 不直接访问文件系统或网络 |
| 工具层 | 执行具体操作 | 不决定调用哪个工具 |
五个组件的简要关系如下图:
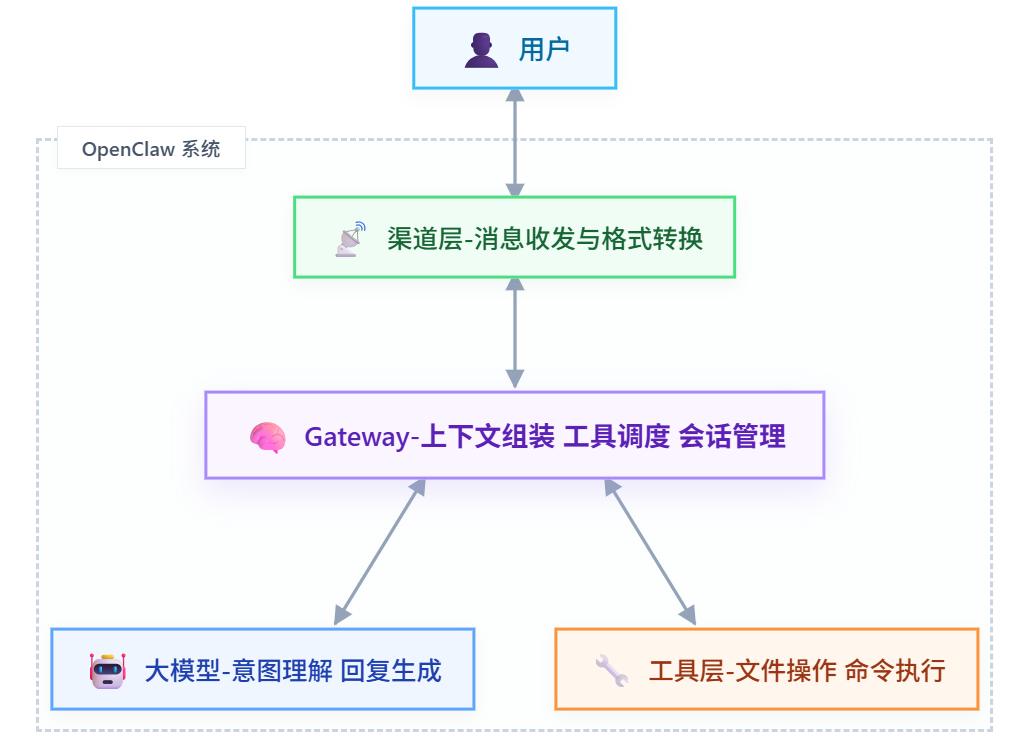
理解了各组件的职责边界,接下来俯瞰整个处理流程。
3. 流程总览
3.1 五个阶段
一条消息从发送到回复,大致经历五个阶段。每个阶段都有明确的目标和参与者:
| 阶段 | 名称 | 主要参与者 | 做什么 |
|---|---|---|---|
| 第 1 阶段 | 消息接收与上下文组装 | 渠道层 → Gateway | 接收消息,组装系统提示、加载历史、搜索记忆 |
| 第 2 阶段 | 大模型思考与决策 | Gateway → LLM | 理解意图,规划需要调用的工具 |
| 第 3 阶段 | 工具执行 | Gateway → 工具层 | 执行工具调用,收集结果 |
| 第 4 阶段 | 回复生成 | Gateway → LLM | 整合工具结果,生成自然语言回复 |
| 第 5 阶段 | 消息发送 | Gateway → 渠道层 → 用户 | 将回复推送回用户 |
用一张消息流程图来直观展示这五个阶段的关系:
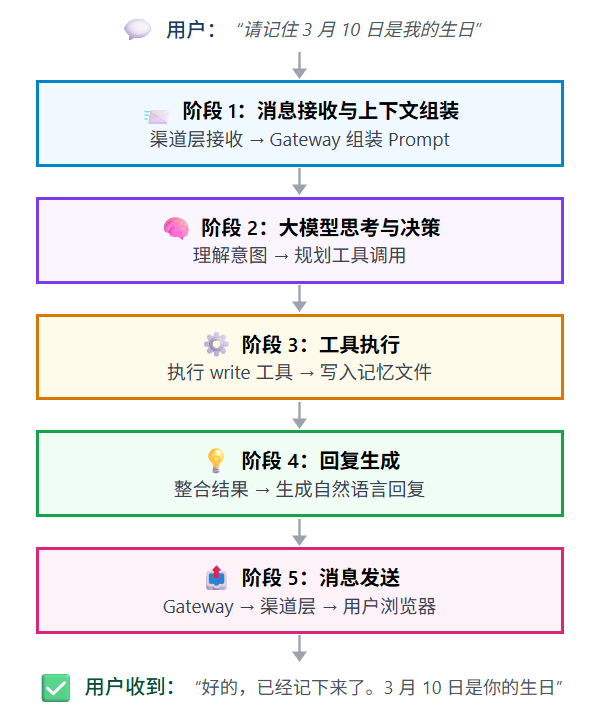
这五个阶段环环相扣,形成完整的处理链路。任何一个环节出现问题,都可能导致整个流程失败。但设计良好的系统会在每个阶段都设置错误处理机制,确保即使部分环节出错,也能优雅降级而不是完全崩溃。
3.2 完整时序图与数据流
为了帮助读者更直观地理解整个流程,下面是各组件在五个阶段中的交互时序:
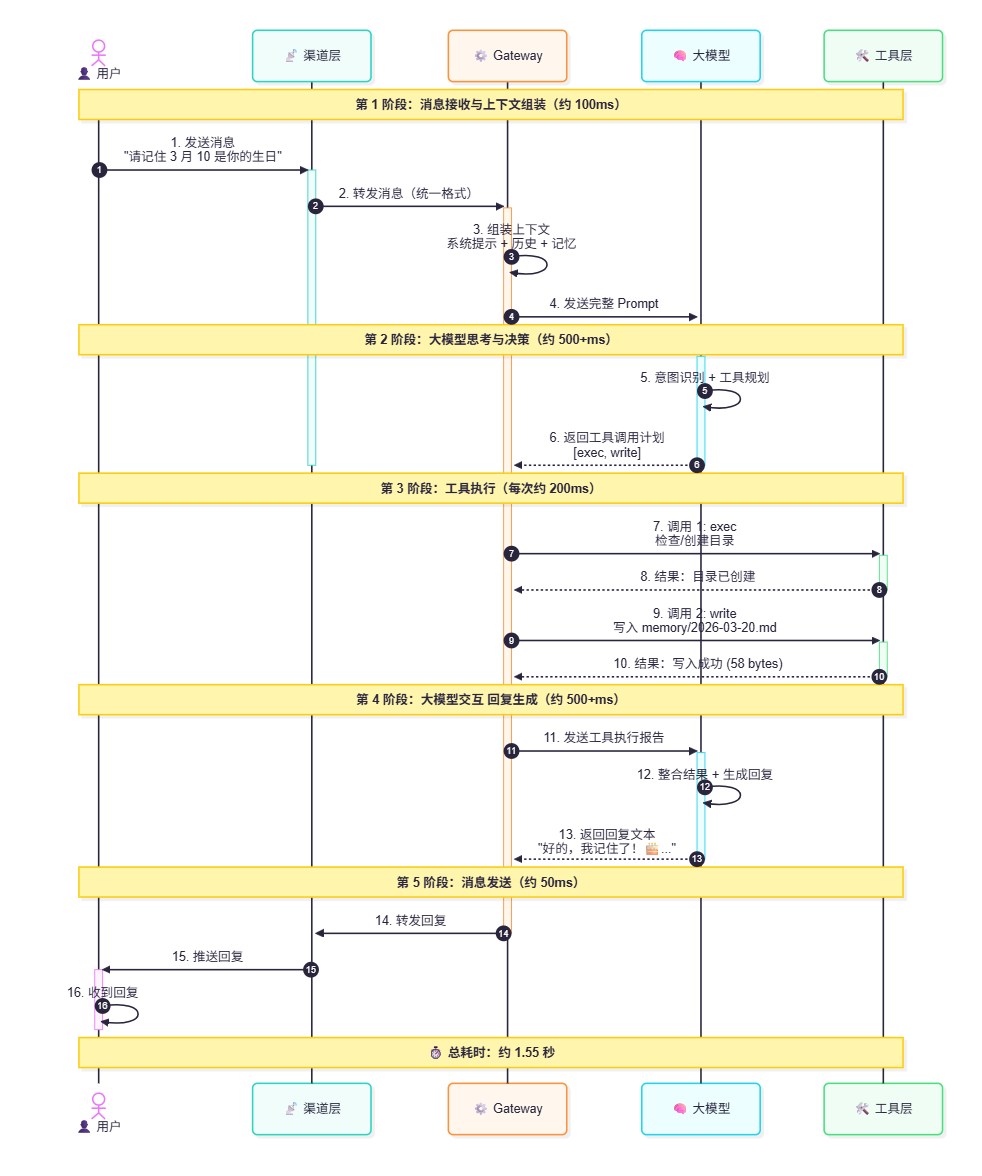
从时序图中可以清楚地看到:
- 用户只与渠道层交互,不直接接触 Gateway 或大模型
- Gateway 是唯一的调度中心,所有组件间的通信都经过它
- 大模型被调用两次:第一次用于决策(规划工具),第二次用于表达(生成回复)
- 工具层只与 Gateway 通信,不知道大模型和用户的存在
这种清晰的层次结构,使得系统的每个部分都可以独立演进和替换。
下面用一个具体例子来走一遍完整流程。
4. 实例解析:"请记住我的生日"
4.1 第 1 阶段:消息接收与上下文组装
这是整个流程的起点,目标是将用户消息转换为大模型可以理解的完整 Prompt(提示词,发送给大模型的完整输入文本)。
渠道层通过 WebSocket 接收到用户消息,提取核心字段(文本内容、发送时间、会话 ID),转换为 OpenClaw 内部统一格式,转发给 Gateway。
Gateway 收到消息后,开始组装完整的 Prompt。这个过程包含四个步骤:
(1)加载系统提示 => (2)加载会话历史 => (3)搜索相关记忆 => (4) 拼接完整 Prompt
步骤一:加载系统提示。 系统提示告诉大模型"你是谁、能做什么、应该遵循什么规则",内容包括工具定义、可用技能列表、安全规则、工作区信息等。这些信息来自 IDENTITY.md、SOUL.md、AGENTS.md 等文件,总量可能达到数千个 Token。
步骤二:加载会话历史。 系统加载最近若干轮对话(轮数可配置,通常 10 到 50 轮),让大模型能够理解当前对话的上下文。如果用户刚刚聊过天气,大模型就能理解"也帮我记住这个"中的"这个"指什么。
步骤三:搜索相关记忆。 以用户当前消息为查询条件,查找与当前请求相关的记忆片段,底层通常是 RAG(检索增强生成) 或 向量数据库(Vector Database) 技术。然后注入到 Prompt 中。如果用户之前提到过生日,系统会把这些记录找出来。如果没有相关记忆,这一步返回空结果。
步骤四:拼接完整 Prompt。 将系统提示、会话历史、记忆片段、用户消息拼接成一个完整的字符串,准备发送给大模型。
在这一阶段,可能遇到的错误包括:
| 错误类型 | 影响 | 处理方式 |
|---|---|---|
| 渠道连接失败 | 消息无法到达 Gateway | 用户会立即感知,需要重连 |
| 系统提示加载失败 | 大模型缺少行为指引 | 使用默认系统提示降级 |
| 会话历史加载失败 | 大模型缺少对话上下文 | 跳过历史,仅保留当前消息 |
| 记忆搜索失败 | 无法注入相关记忆 | 跳过记忆注入,不影响后续流程 |
除渠道连接失败外,其他错误对用户是透明的,系统会优雅降级继续处理。
组装完成后,Gateway 将完整 Prompt 发送给大模型,进入下一个阶段。
4.2 第 2 阶段:大模型思考与决策
这是整个流程的"决策中心",目标是大模型理解用户意图并规划需要调用的工具。
大模型收到完整 Prompt 后,开始分析用户意图。"请记住 3 月 10 日是我的生日"这句话中,"请记住"是核心动词,表示需要将信息持久化存储。"3 月 10 日是我的生日"是要存储的具体内容。
大模型回顾系统提示中定义的工具列表,判断需要调用哪些工具来完成这个请求。对于"记住生日"这个请求,最直接的方式是使用 write 工具,将信息写入每日记忆文件。
大模型生成工具调用计划,以 JSON 格式告诉 Gateway 需要执行什么操作、用什么参数:
{
  "tool": "write",
  "arguments": {
    "path": "memory/2026-03-20.md",
    "content": "- 用户告知:3 月 10 日是他的生日"
  }
}
Gateway 收到计划后,验证工具名称是否合法、参数是否完整,准备执行。
可能遇到的错误包括:
| 错误类型 | 说明 | 处理方式 |
|---|---|---|
| 大模型超时 | 网络延迟或服务端繁忙 | 自动重试,超时后告知用户 |
| 工具计划格式错误 | JSON 解析失败 | 要求大模型重新生成 |
| 工具参数不合法 | 路径越权、参数缺失 | 拒绝执行,返回错误信息 |
| 认证过期 | API Key 失效 | 提示用户更新配置 |
这些错误都会反馈给用户,需要用户干预或重试。
4.3 第 3 阶段:工具执行
这是整个流程的"执行中心",目标是将大模型的抽象计划转化为具体的系统操作。
Gateway 调用 write 工具,将指定内容写入 memory/2026-03-20.md 文件。文件写入成功后,工具返回执行结果:
Successfully wrote 58 bytes to memory/2026-03-20.md
Gateway 将执行结果返回给大模型,准备生成回复。
如果这个请求需要多个工具协作,Gateway 会根据工具之间的依赖关系决定执行方式:
场景 A:有依赖关系 → 串行执行

  ┌──────────────┐     ┌──────────────┐
  │ 工具 1:检查  │ ──→ │ 工具 2:写入  │
  │ 目录是否存在  │     │ 文件         │
  └──────────────┘     └──────────────┘

场景 B:无依赖关系 → 并行执行

  ┌──────────────────┐
  │ 工具 1:查北京天气 │ ──┐
  └──────────────────┘   │ 同时执行,总耗时 = max(A, B)
  ┌──────────────────┐   │
  │ 工具 2:查上海天气 │ ──┘
  └──────────────────┘
简单来说:有依赖关系的工具串行执行(先检查目录是否存在再写入文件),没有依赖关系的工具可以并行执行(同时查询多个城市的天气),总耗时取决于最慢的那个调用,而不是所有调用的累加。
可能遇到的错误包括:
| 错误类型 | 说明 | 处理方式 |
|---|---|---|
| 文件权限不足 | 工作区目录只读 | 返回错误,提示用户检查权限 |
| 网络连接超时 | 外部 API 不可达 | 自动重试,失败后告知大模型 |
| 命令执行失败 | Shell 命令返回非零退出码 | 返回错误输出,由大模型决策 |
| 工具不存在 | 大模型幻觉了工具名 | 返回错误,要求重新规划 |
Gateway 会捕获这些错误,根据情况重试或告知用户。
4.4 第 4 阶段:回复生成
这是整个流程的"表达中心",目标是将技术性的工具结果转化为用户能理解的自然语言回复。
大模型收到工具执行结果后,需要完成三件事:
- 理解技术结果:将"Successfully wrote 58 bytes"翻译为人类可理解的含义
- 关联上下文:将结果与之前的对话联系起来,形成连贯的回复
- 匹配风格:参考
SOUL.md中定义的风格规范,决定回复的语气和用词
最终生成的回复可能是:
好的,已经记下来了。3 月 10 日是你的生日,以后我会记住的。🎂
从"Successfully wrote 58 bytes"到"好的,已经记下来了",这个转化过程就是大模型的表达能力在发挥作用。
可能遇到的错误包括大模型超时、回复生成失败、回复过长等。系统会自动重试或使用默认回复,确保用户至少能得到一个响应。
4.5 第 5 阶段:消息发送
这是整个流程的"最后一公里",目标是将生成的回复发送给用户。
Gateway 将回复文本转发给渠道层,渠道层根据会话元数据中的渠道信息,选择对应的渠道插件:
| 渠道 | 发送方式 | 特殊处理 |
|---|---|---|
| webchat | WebSocket 推送 | 支持流式输出(逐字显示) |
| Telegram | Bot API sendMessage |
支持 Markdown 格式 |
| Discord | Gateway API | 消息长度限制 2000 字符,需分段 |
| Business API | 不支持 Markdown 表格 | |
| Slack | Events API | 支持 Block Kit 富文本 |
发送完成后,渠道层将结果返回给 Gateway。Gateway 记录完整的请求处理日志,包括响应时间、Token 消耗、工具调用次数等指标,用于后续的性能分析和成本核算。
可能遇到的错误包括认证过期、网络错误、渠道限流、消息太长等。渠道层会自动重试或截断处理,确保尽可能送达。
至此,一条消息的完整旅程结束。从用户按下发送键到看到回复,整个过程通常在 1 到 3 秒内完成。
5. 流程优化与性能调优
理解流程的最终目的是优化流程。以下是几个常见的优化方向,适用于开发者和高级用户。
5.1 减少工具调用次数
这是最直接的优化手段。很多时候,多个命令可以合并为一个命令执行。
优化前(2 次工具调用):
调用 1:exec("ls skills/")          → 检查目录是否存在
调用 2:exec("mkdir -p skills/new")  → 创建目录
优化后(1 次工具调用):
调用 1:exec("mkdir -p skills/new") → mkdir -p 自带"不存在则创建"语义
每次工具调用都有固定开销(大模型思考时间 + 网络往返 + 执行时间),减少调用次数可以直接降低响应时间和 Token 消耗。
5.2 并行化独立工具调用
如果多个工具调用之间没有依赖关系,可以同时发起而不是串行等待。
场景:查询三个城市的天气

串行:web_search("北京天气") → web_search("上海天气") → web_search("广州天气")
      总耗时 = T1 + T2 + T3 ≈ 3 秒

并行:web_search("北京天气") ┐
      web_search("上海天气") ├── 同时执行
      web_search("广州天气") ┘
      总耗时 = max(T1, T2, T3) ≈ 1 秒
简单来说:能并行就并行,总耗时取决于最慢的那个调用,而不是所有调用的累加。
5.3 精简系统提示
系统提示中包含大量工具和技能的定义,但很多请求只用其中一小部分。精简系统提示可以减少 Token 消耗:
| 优化手段 | 说明 | 效果 |
|---|---|---|
| 保持 SKILL.md 简洁 | 建议小于 5000 tokens | 减少输入 Token 数量 |
| 只加载必要技能 | 不相关的技能不注入系统提示 | 降低噪音,提升理解准确度 |
| 压缩工具描述 | 用精炼的语言描述工具用途 | 减少系统提示体积 |
5.4 缓存重复读取的内容
如果同一个文件在短时间内被多次读取,可以缓存第一次读取的结果,后续直接返回缓存。
场景:同一轮对话中多次读取 AGENTS.md

第 1 次:read("AGENTS.md")  → 从磁盘读取,结果写入缓存
第 2 次:read("AGENTS.md")  → 直接返回缓存内容,跳过磁盘 I/O
缓存需要设置合理的失效时间,确保数据的一致性。一般来说,单次对话内的缓存是安全的,跨对话则需要更谨慎的策略。
5.5 优化建议总结
| 优化方向 | 适用场景 | 预期收益 | 注意事项 |
|---|---|---|---|
| 减少调用次数 | 多步骤可合并的操作 | 降低延迟和 Token 消耗 | 不要牺牲可读性 |
| 并行化调用 | 多个独立查询 | 显著缩短总耗时 | 确保工具间无依赖 |
| 精简系统提示 | Token 消耗过高 | 降低成本,提升理解 | 不能删除必要信息 |
| 缓存读取结果 | 重复读取同一文件 | 减少 I/O 开销 | 注意缓存失效策略 |
这些优化手段需要根据实际情况权衡使用。过度优化可能增加系统复杂度,反而降低可靠性。最好的策略是先保证正确性,再根据性能监控数据有针对性地优化瓶颈环节。
6. 总结与进阶
6.1 本章核心知识回顾
本章通过一个具体的案例,详细解析了 OpenClaw 处理用户请求的完整流程。以下是核心要点回顾:
| 知识模块 | 核心要点 |
|---|---|
| 组件职责 | 用户是起点和终点;渠道层做格式转换;Gateway 是核心调度器;大模型负责思考和表达;工具层负责执行 |
| 架构原则 | Gateway 是唯一与大模型交互的组件;渠道层和工具层都与大模型解耦 |
| 五阶段流程 | 消息接收 → 思考决策 → 工具执行 → 回复生成 → 消息发送 |
| 大模型交互 | 至少两轮:第一轮决策(工具调用计划),第二轮表达(自然语言回复) |
| 错误处理 | 每个阶段都有降级策略,非致命错误对用户透明 |
| 性能优化 | 减少调用、并行化、精简提示、缓存读取 |
6.2 关键设计理念
回顾本章内容,有三个设计理念贯穿始终:
第一,关注点分离。 每个组件只做自己擅长的事。渠道层不碰大模型,工具层不做决策,大模型不直接操作系统。这种分离使得每个部分都可以独立演进和替换。
第二,中心化调度。 Gateway 作为唯一的调度中心,集中管理状态、权限和日志。这避免了分布式状态同步的复杂性,也让问题排查更加简单。
第三,优雅降级。 系统在每一步都考虑了失败的可能性。记忆搜索失败不影响对话,工具执行失败可以重试,回复生成失败有兜底方案。这种设计确保了系统的鲁棒性。
6.3 课后练习
-
基础题:当用户输入“您好”,统计一下OpenClaw所花费的token数量,以及他花在什么地方。
-
进阶题:打开 OpenClaw 的日志文件,找到一次完整的请求处理记录,标注出五个阶段分别对应的日志行。观察每个阶段的耗时,哪个阶段最慢?
本章完
本文为《OpenClaw 实战指南》系列第 7 篇。下一章,我们将深入了解 OpenClaw 的定时任务机制。结合本章的流程知识,你可以构建出真正有用的自动化助手。